初稿: 2026-07-14
はじめに
過去にオセロAIや麻雀AIを個人で作った経験があり、麻雀AIに取り組んだ際にPPO(強化学習の一手法)という技術を知った。そこから自然と、次は言語モデルそのものを一から作ってみたいという気持ちが芽生えた。
直接のきっかけは、Anthropic社の先端モデル(Claude Mythos等)が米国の輸出規制によって一時的に利用停止になったというニュースだった。国家の判断ひとつで海外の先端AIへのアクセスが止まりうるという事実を目の当たりにし、日本国内に大規模言語モデルを自前で開発できる基盤がほとんどないことに危機感を覚えた。国際競争力の観点はもちろん、自国の情報を自国の技術で扱えないという点も気にかかった。
そうした問題意識に加えて、個人が限られたリソースだけでどこまで言語モデルを作れるのかを純粋に試してみたい、という好奇心もあった。将来的にはゲームAIへの組み込みやDiscord bot化といった、単純に「作って動かして楽しい」使い道も見据えている。
本記事は、その一連の試行錯誤を個人の記録として残すとともに、同じ規模感で挑戦しようとする後続の誰かの参考になることを目的として書いている。
結論を先に述べると、家庭用GPU(VRAM 8GB)1枚でも109.53Mパラメータ規模の言語モデルを事前学習からSFT、さらにRAGを組み合わせた推論パイプラインまで構築することは十分に可能である。一方で、その言語能力に過度な期待をかけるのは禁物で、日本語らしい文法・文体は獲得できても、事実の一貫性や知識量の面では実用に耐える水準にはほど遠い。「作れるかどうか」と「使い物になるかどうか」は別問題である、というのが今回得られた率直な結論。
目次
- ハードウェア環境
- ソフトウェア・実行環境
- データセット
- トークナイザ
- モデルアーキテクチャ
- 学習パラメータ(Training Config)
- 学習結果
- 学習時間
- トラブルシューティング
- 生成サンプル
- SFT
- RAGの適用
- 次にやりたいこと
- これから作る人へ
- 謝辞
- コード
- 参考文献
1. ハードウェア環境
| 項目 | 内容 |
|---|---|
| OS | Windows |
| RAM | 32GB |
| GPU | NVIDIA GeForce RTX 5060 |
| VRAM | 8GB |
2. ソフトウェア・実行環境
| 項目 | 内容 |
|---|---|
| 仮想環境 | Docker(docker-compose) |
| 言語・ライブラリ | Python 3.10 / PyTorch(CUDA対応) |
| データ型 | bfloat16 |
3. データセット
| 項目 | 内容 |
|---|---|
| 総トークン数 | 2,000,000,127 トークン |
| 保存形式 | 分割バイナリファイル(.bin) |
| 読み込み方式 | np.memmap によるオンメモリ非展開でのランダムアクセス |
コーパス比率
| コーパス | 比率 |
|---|---|
matsuo-lab/JP-LLM-Corpus-PII-Filtered-10B |
50% |
wikimedia/wikipedia(20231101.ja) |
30% |
globis-university/aozorabunko-clean |
20% |
4. トークナイザ
| 項目 | 内容 |
|---|---|
| アルゴリズム | ByteLevel BPE |
| 正規化 | NFKC |
| 語彙数 | 32,000 |
| 設定パラメータ | limit_alphabet=6000 |
5. モデルアーキテクチャ
| 項目 | 内容 |
|---|---|
| 総パラメータ数 | 109.53M(約1億パラメータ) |
| レイヤー数(n_layers) | 12 |
| アテンションヘッド数(n_heads) | 12 |
| 隠れ層サイズ(d_model) | 768 |
| 最大文脈長(max_seq_len) | 2048 |
設計としてはLlama系アーキテクチャに準拠したフルスクラッチ実装で、GPT-2系の標準的な構成(絶対位置埋め込み・LayerNorm・GELU)ではなく以下の要素を採用している。
| 要素 | 採用手法 |
|---|---|
| 位置エンコーディング | RoPE(Rotary Positional Embeddings) |
| 正規化 | RMSNorm(Pre-Norm配置) |
| フィードフォワード | SwiGLU(隠れ次元は 8/3 × d_model を256の倍数に切り上げ) |
| Attention実装 | PyTorch scaled_dot_product_attention(Flash Attention/メモリ効率実装が自動選択される) |
| 重み共有 | 入力埋め込みと出力層(lm_head)でweight tying |
| 重み初期化 | 正規分布(std=0.02) |
Attentionモジュール自体はGQA(Grouped Query Attention、n_kv_heads を n_heads より少なくする設計)に対応した実装になっているが、今回の学習では n_kv_heads を明示的に指定せず n_heads と同数のまま使用しているため、実質的には通常のMulti-Head Attentionとして動作している。
各TransformerBlockはPre-Norm構成(x + Attention(RMSNorm(x))、h + SwiGLU(RMSNorm(h)))で、Attention → RMSNorm → 残差接続 → SwiGLU → RMSNorm → 残差接続という流れを12層分スタックしている。
5.1 実装コード(抜粋)
正規化層はRMSNorm。
class RMSNorm(nn.Module):
    def __init__(self, dim: int, eps: float = 1e-6):
        super().__init__()
        self.eps = eps
        self.weight = nn.Parameter(torch.ones(dim))

    def _norm(self, x):
        return x * torch.rsqrt(x.pow(2).mean(-1, keepdim=True) + self.eps)

    def forward(self, x):
        output = self._norm(x.float()).type_as(x)
        return output * self.weight
フィードフォワード層はSwiGLU。隠れ次元は 8/3 × d_model を256の倍数に切り上げて決定している。
class SwiGLU(nn.Module):
    def __init__(self, d_model: int, hidden_dim: int):
        super().__init__()
        self.w1 = nn.Linear(d_model, hidden_dim, bias=False)
        self.w2 = nn.Linear(hidden_dim, d_model, bias=False)
        self.w3 = nn.Linear(d_model, hidden_dim, bias=False)

    def forward(self, x):
        return self.w2(torch.nn.functional.silu(self.w1(x)) * self.w3(x))
TransformerBlockはPre-Norm構成で、Attention・SwiGLUそれぞれの前にRMSNormを挟み、残差接続で足し戻す。
class TransformerBlock(nn.Module):
    def forward(self, x: torch.Tensor, freqs_cis: torch.Tensor):
        h = x + self.attention(self.attention_norm(x), freqs_cis)
        out = h + self.feed_forward(self.ffn_norm(h))
        return out
Attentionは位置エンコーディングにRoPEを使い、実際の計算はPyTorch標準の scaled_dot_product_attention(is_causal=True)に委ねている。これによりFlash Attention系の最適化カーネルが、実行環境やテンソル形状などの条件に応じて自動的に選択される。
def forward(self, x: torch.Tensor, freqs_cis: torch.Tensor):
    bsz, seqlen, _ = x.shape
    xq, xk, xv = self.wq(x), self.wk(x), self.wv(x)

    xq = xq.view(bsz, seqlen, self.n_local_heads, self.head_dim)
    xk = xk.view(bsz, seqlen, self.n_local_kv_heads, self.head_dim)
    xv = xv.view(bsz, seqlen, self.n_local_kv_heads, self.head_dim)

    xq, xk = apply_rotary_emb(xq, xk, freqs_cis=freqs_cis)

    xq = xq.transpose(1, 2)
    xk = xk.transpose(1, 2)
    xv = xv.transpose(1, 2)

    output = torch.nn.functional.scaled_dot_product_attention(
        xq, xk, xv, attn_mask=None, dropout_p=0.0, is_causal=True
    )

    output = output.transpose(1, 2).contiguous().view(bsz, seqlen, -1)
    return self.wo(output)
6. 学習パラメータ(Training Config)
| 項目 | 内容 |
|---|---|
| 総学習ステップ数 | 16,000 ステップ |
| 物理バッチサイズ | 2 |
| 勾配累積(Gradient Accumulation) | 32 |
| 実効バッチサイズ | 64 |
| 最大学習率(Max LR) | 6.0e-4 |
| 最小学習率(Min LR) | 6.0e-5 |
| ウォームアップステップ数 | 40 |
| 学習率スケジューラ | ウォームアップ付きコサイン減衰 |
| オプティマイザ | AdamW(betas=(0.9, 0.95)、eps=1e-8) |
| Weight Decay | 0.1 |
| 勾配クリッピング(max norm) | 1.0 |
| データ抽出方式 | PyTorch DataLoader(shuffle=True)によるランダムバッチサンプリング |
| train/val分割 | 90% / 10% |
| Early Stopping | 検証損失が5回連続で改善しなければ打ち切り |
| 評価・チェックポイント間隔 | 500ステップごと |
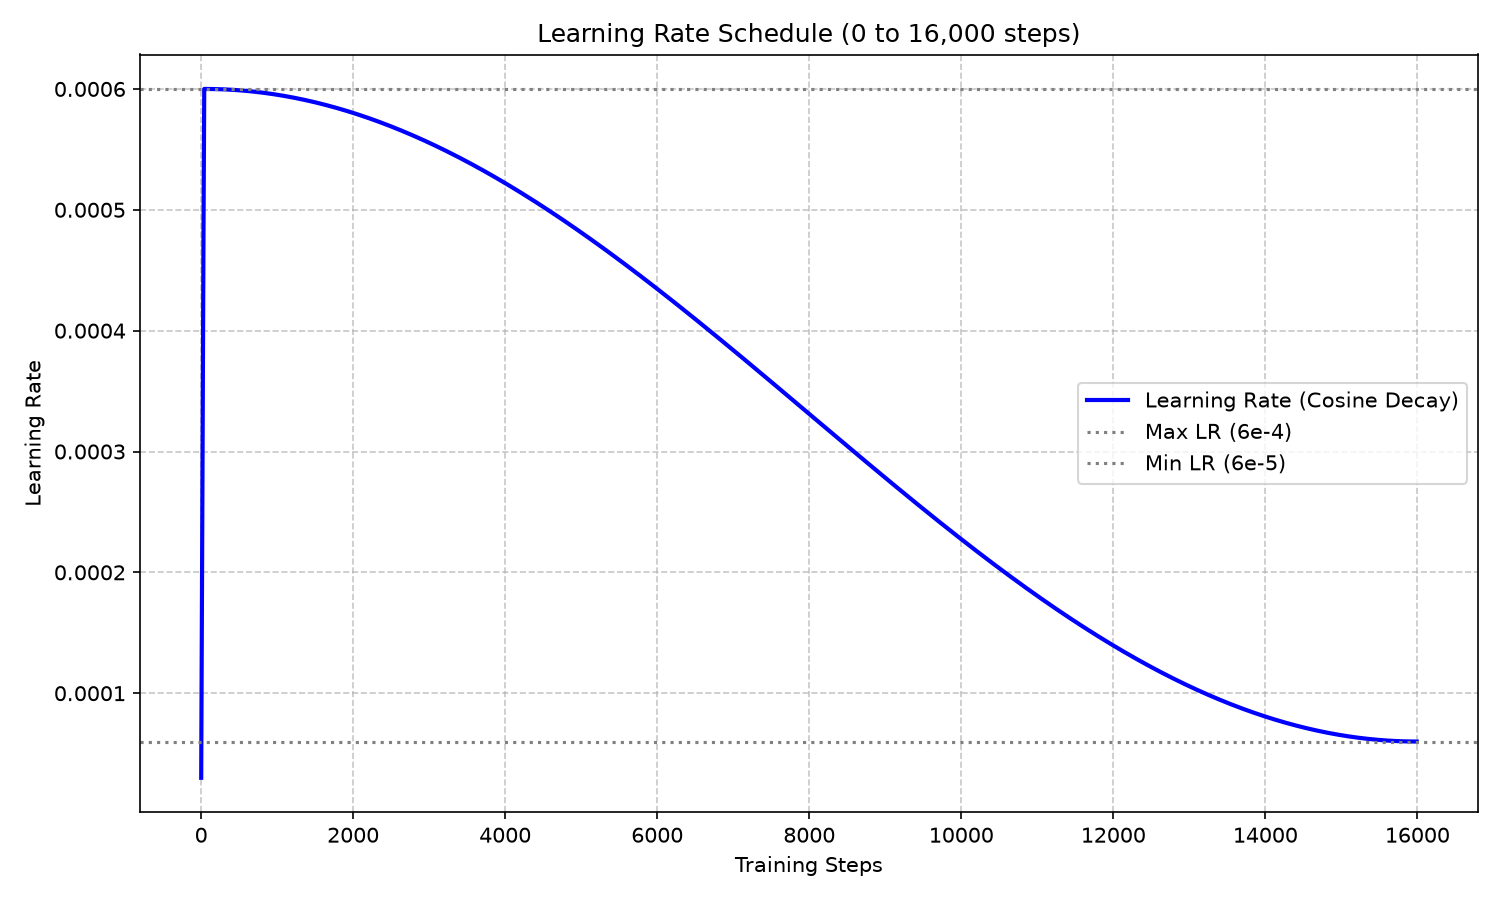
短いウォームアップの後、最大学習率 6.0e-4 に到達し、16,000ステップかけてコサイン減衰で 6.0e-5 まで下がっていく様子が確認できる。
7. 学習結果
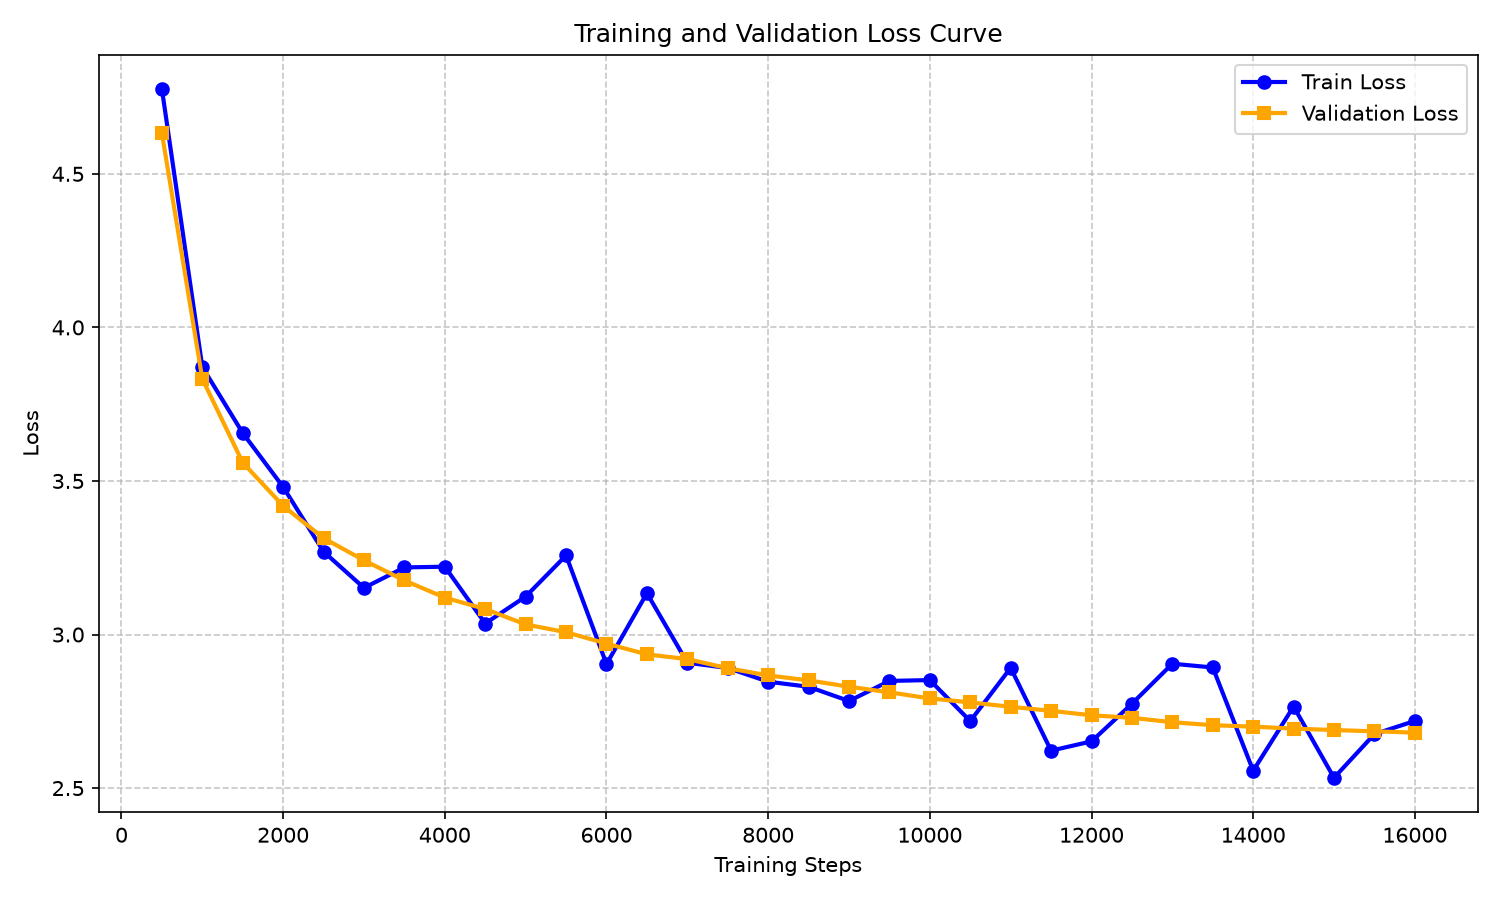
学習開始直後は損失が急激に下がり、6,000ステップ前後でおよそ3.0付近まで収束していく。以降は緩やかな低下に移り、16,000ステップ時点では学習損失・検証損失ともに2.6〜2.7程度に落ち着いている。学習損失の方が振れ幅が大きいのに対し、検証損失は比較的滑らかに推移している。
8. 学習時間
| 項目 | 内容 |
|---|---|
| 開始 | 2026-07-11 05:52:56 (UTC) |
| 完了 | 2026-07-12 04:28:04 (UTC) |
| 総学習時間 | 81,287.8 秒(約22時間35分) |
| 総学習ステップ数 | 16,000 ステップ |
| 平均ステップ時間 | 約 5.08 秒/step |
| スループット | 約 25,800 tokens/sec |
| 総処理トークン数 | 約21億トークン |
109.53Mパラメータに対して約21億トークンという学習量は、経験則として知られるChinchilla則(パラメータ数の約20倍のトークン数が計算最適とされる目安)に照らすと、109.53M × 20 ≒ 2.19Bとほぼ一致しており、この規模のモデルとしては妥当な学習量だったと言える。
VRAM 8GBというコンシューマ向けGPU一枚でも、約1日でこの規模の事前学習を一通り回し切れる、という参考値になる。
なお、学習完了後にPCを自動シャットダウンする処理も仕込んでいたが(就寝中に終わった場合を想定)、想定していたタイミングでは学習が終わらなかったため、結局使わなかった。
9. トラブルシューティング
限られたハードウェアリソース(システムRAM・VRAM 8GB)でこの規模の学習を回すにあたり、複数のOOM(メモリ不足)に直面した。それぞれの原因と対策は以下の通り。
9.1 トークナイザ学習時のOOM(システムRAM)
- 原因: 日本語特有の数万に及ぶ漢字種により、BPEアルゴリズムの初期段階で扱う文字ペアの組み合わせ数・計算量が急激に増加し、メモリ消費が膨れ上がった。
- 対策:
limit_alphabet=6000を設定し、出現頻度の極端に低い文字種を初期処理から除外した。
trainer = BpeTrainer(
    vocab_size=32000,
    min_frequency=2,
    special_tokens=["<unk>", "<s>", "</s>", "<pad>"],
    limit_alphabet=6000,  # 日本語特有の「無数にある漢字」によるペア数の爆発を防ぐ
    show_progress=True
)
9.2 データセット抽出時のOOM(システムRAM)
- 原因: 松尾研コーパスにおいて、1行のJSONL内に1,400件の記事データが格納されている特殊構造を一括展開しようとした。
- 対策:
streaming=Trueによるオンザフライ通信を有効化し、1行分(1,400件)をバッファに展開したら、そこから1件ずつ消費する形にして一括展開を避けた。
ds_matsuo = load_dataset(
    'matsuo-lab/JP-LLM-Corpus-PII-Filtered-10B', split='train', streaming=True
)
iter_matsuo = iter(ds_matsuo)
matsuo_buffer = []

# 1行のJSONLに1,400件の記事が格納されているため、
# 一度読み込んだらバッファに展開し、1件ずつpopして消費する
if not matsuo_buffer:
    row = next(iter_matsuo)
    jsonl_data = row['jsonl']
    if isinstance(jsonl_data, bytes):
        jsonl_data = jsonl_data.decode('utf-8')
    for line in jsonl_data.strip().split('\n'):
        if not line:
            continue
        data = json.loads(line)
        t = data.get("text", "").strip()
        if t:
            matsuo_buffer.append(t)

if matsuo_buffer:
    text = matsuo_buffer.pop()
9.3 学習データ読み込み時のOOM(システムRAM)
- 原因: 20億トークン分(約4GB)のバイナリデータを、学習ループ時に一括してPythonのメモリ空間へロードしようとした。
- 対策:
np.memmapを導入し、データをRAMへ展開せずSSD上のファイルから直接インデックス参照する仮想メモリマッピング方式へ変更した。
class BinaryTokenDataset(Dataset):
    def __init__(self, data_dir, seq_len):
        self.seq_len = seq_len
        self.files = sorted(glob.glob(os.path.join(data_dir, "*.bin")))

        # メモリを食い潰さないように全チャンクをメモリマップ(mmap)で仮想的に読み込む
        self.cum_tokens = [0]
        self.mmap_files = []
        for f in self.files:
            m = np.memmap(f, dtype=np.uint16, mode='r')
            self.mmap_files.append(m)
            self.cum_tokens.append(self.cum_tokens[-1] + len(m))

        self.total_tokens = self.cum_tokens[-1]
        self.num_samples = self.total_tokens // (seq_len + 1)

    def __getitem__(self, idx):
        start = idx * self.seq_len
        chunk_idx = bisect.bisect_right(self.cum_tokens, start) - 1
        local_start = start - self.cum_tokens[chunk_idx]
        chunk = self.mmap_files[chunk_idx]

        data = chunk[local_start:local_start + self.seq_len + 1].astype(np.int64)
        x = torch.tensor(data[:-1], dtype=torch.long)
        y = torch.tensor(data[1:], dtype=torch.long)
        return x, y
9.4 モデル学習時のOOM(GPU VRAM)
- 原因: 100Mパラメータ、文脈長2048、バッチサイズ64のアクティベーション保持に必要な容量が、RTX 5060のVRAM上限(8GB)を超過した。
- 対策1: 物理バッチサイズを限界値の「2」に縮小し、「32」ステップ分の勾配を内部ストックしてから更新する勾配累積(Gradient Accumulation)を実装した。
- 対策2:
torch.autocastによるbfloat16(半精度浮動小数点数)混合精度学習を適用し、VRAM消費量を半減させた。
BATCH_SIZE = 2          # VRAM 8GB上限のため、物理バッチサイズを最小限に
GRAD_ACCUM_STEPS = 32   # 実効バッチサイズ = 2 * 32 = 64

optimizer.zero_grad(set_to_none=True)

for _ in range(GRAD_ACCUM_STEPS):
    x, y = next(train_iter)
    x, y = x.to(DEVICE), y.to(DEVICE)

    with torch.autocast(device_type=DEVICE, dtype=DTYPE):  # DTYPE = torch.bfloat16
        _, loss = model(x, y)
        loss = loss / GRAD_ACCUM_STEPS

    scaler.scale(loss).backward()

scaler.unscale_(optimizer)
torch.nn.utils.clip_grad_norm_(model.parameters(), MAX_GRAD_NORM)
scaler.step(optimizer)
scaler.update()
10. 生成サンプル
学習済みモデルによる生成例。パラメータは以下の通り。
| パラメータ | 値 |
|---|---|
| 反復ペナルティ | 1.2 |
| temperature | 0.8 |
| top-k | 40 |
| max_new_tokens | 150 |
Prompt: 東京とは
違う。 「マメ」は「女人(女装者)」。「男同士の男性が男として振る舞い、女装する」という意味がある。 人名ではなく、「女」という表現を用いていることが多いことからしばしば混同されるが、日本以外の国の人を指す場合はこの項でまとめて参照した。
男女の区別 男性の場合は、男性と女性の二重婚である。
男女の混血などの場合は、必ずしも二人目のときの2分の1以上の性的不一致を区別しないことに注意する必要がある。また男性の場合は、複数の男性の女性と結婚した場合、両者の一連の性別は両性の関係となるため厳密には同一ではない。
不倫の場合 結婚後の3 - 4年後の年月
Prompt: 日本とは
、中国の伝統的な伝統文化を守っていくことが目的です。それぞれの民族の文化はそれぞれの文化に特徴があり、自分達と違う価値を持つことがあります。 日本とアメリカは違い、文化の違いを共有しています。日本の文化は他の社会と大きく異なる点で異なります。例えば、日本人の多くは、彼らの文化を理解することで世界や世界を理解する傾向がありますが、他の人々がこれらの問題を解決しようとする時、それらの影響を受ける場合があります。【ご予約・お問合せ】 アカネフォトスタジオ ◆10
20歳未満の方(高校生アサイン含む)の皆様へのお願い! 10月21日(金)11月中旬まで休館日とさせていただきます。(営業時間外は電話でのご連絡となります。) ※最終受付時間は変更となる場合がございます
Prompt: アメリカとは
無関係である。
概要 18世紀中頃から19世紀末にかけて、フランスで盛んに行われた料理法の一つに『シャトレーゼ』がある(日本では1840年(天保元年)頃に「イタリア・ピエモンテ」、以降現在の「ピエートロ」と呼ぶ)。これは中世フランスで考案されたとされるが、これは単に「牛肉から野菜を垂らすもの」(preville populaire)、つまり牛の肉を食べさせる肉、あるいは煮て食べさせる肉を指す。鶏肉は牛肉より柔らかく美味く、煮た牛肉は肉よりも柔らかいので、食肉として利用されることも多い。鶏肉も同様に鍋やステーキなどの料理に用いられるが、鶏肉
文法的な破綻は少なく、日本語らしい局所的な統計パターンや文体は獲得しているものの、内容の一貫性は早々に破綻する。「東京とは」と聞いて女装の話が始まり、「日本とは」の途中から急に写真スタジオの予約案内が紛れ込む。おそらく学習データ中のWikipediaの雑多な記事や、Webコーパスに含まれる断片的な広告文がそのまま漏れ出している。
109.53M パラメータ・2Bトークン程度の事前学習では、流暢さの片鱗は見えても実用に足る一貫性は得られない、というのが率直な感触。今回の目的はあくまで事前学習パイプライン(トークナイザ構築からデータ処理、分散なしの単一8GB VRAM環境での学習まで)を一通り自分の手で動かして理解することにあったので、この結果自体は想定の範囲内。
11. SFT
事前学習済みモデルに対し、指示応答形式のデータでSFT(Supervised Fine-Tuning)を実施した。
11.1 データセット
ベースデータには kunishou/databricks-dolly-15k-ja を使用し、以下の条件で選別した。
| 選別条件 | 内容 |
|---|---|
| 対象タスクカテゴリ | open_qa、closed_qa、information_extraction のみ |
| ユーザ入力(質問+文脈)の長さ | 60文字以下 |
| AI出力(回答)の長さ | 80文字以下 |
| 除外条件 | 回答に 1. や * などのリスト形式が含まれるものを除外 |
| 抽出件数 | 選別後のデータからランダムに2,000件 |
タスクカテゴリを3種に絞り、かつ入出力を短文に限定しているのは、109.53Mパラメータ・文脈長2048というモデル規模に対して、長い文脈や複雑な指示(要約・創作・分類など)はまだ手に余ると判断したため。短く自己完結した質問応答に絞ることで、限られたモデル容量でも「型」を学習しやすくする狙いがある。
11.2 学習設定
| 項目 | 内容 |
|---|---|
| 学習データ件数 | 2,000件 |
| エポック数 | 3 |
SFTは事前学習時(1章)とは異なり、MacBook Air(M5、
mpsデバイス)上で実行した。
エポックごとの平均損失
| エポック | Average Loss |
|---|---|
| 1 | 1.5017 |
| 2 | 1.1061 |
| 3 | 0.7799 |
11.3 プロンプトテンプレート
学習データはChatML形式のテンプレートに整形して投入した。
<|im_start|>system
あなたは親切なAIアシスタントです。<|im_end|>
<|im_start|>user
こんにちは<|im_end|>
<|im_start|>assistant
11.4 SFT後の生成サンプル
10章と同じ3つのプロンプト・同じ生成パラメータ(反復ペナルティ1.2、temperature 0.8、top-k 40、max_new_tokens 150)で、SFT後のモデルに生成させた結果は以下の通り。
User: 東京とは
東京は、主に日本の歴史的な場所・都市の1つとして描かれる領域ですが、地方自治体や民間企業によって様々な地域があるため、「東京」という地名は存在します。
User: 日本とは
日本は、現在、中国とアメリカの一部であり、中国は世界の領土である。
User: アメリカとは
アメリカは、文明の発展とともに発展したヨーロッパの一部である
base(10章)と比べると、まず出力の長さが大きく変わった。base は文脈が続く限りだらだらと生成を続け、途中で無関係な話題(写真スタジオの予約案内など)に脱線していたが、SFT後は1〜2文で応答が終わるようになっている。これは学習データを80文字以下の短い回答に絞ったことがそのまま反映された結果で、「質問には短く答えて終わる」という応答の型は確かに獲得できている。
一方で内容の正確性は改善していない。「日本は中国とアメリカの一部」「アメリカはヨーロッパの一部」といった誤りは、baseで見られた事実誤認や地理感覚の欠如がそのまま持ち越されている。2,000件・3エポックというこの規模・データ量のSFTは、応答の「型」や振る舞いの改善には寄与するものの、広範な知識の追加にはあまり向かない、という想定通りの結果になった。
12. RAGの適用
12.1 プロンプトベースのRAG
SFT済みモデルに対し、追加学習を行わずに検索結果をプロンプトに埋め込む形でのRAG(Retrieval-Augmented Generation)を試したところ、こちらはまあまあうまく機能した。モデル自体は変更せず、質問に関連する文脈をプロンプトに含めて渡すだけの構成。検索対象のコーパスは50件のみと小規模で、生成パラメータはtemperatureのみ0.1に下げ、他は10章・11章と同じ(反復ペナルティ1.2、top-k 40、max_new_tokens 150)。
User: 東京とは
検索結果(上位2件、コサイン類似度スコア付き):
- Score 0.8682: 「日本の公用語は法律で明記されていないが、事実上日本語のみであ...」
- Score 0.8390: 「京都市はかつて平安京として794年に都が置かれた都市で、明治...」
東京は、東京市(とうきょうと)とも呼ばれ、日本の首都であり、日本を代表する観光地である。東京ディズニーリゾートの最寄駅は、東京駅から約2.5kmの距離にある「東京ベイサイドライン」である。東京ディズニーランドや東京ディズニーシーなどの大都市圏へのアクセスも良く、東京ディズニーリゾートの観光名所としては最も歴史のある場所である。
User: 日本とは
検索結果(上位2件):
- Score 0.8621: 「日本の公用語は法律で明記されていないが、事実上日本語のみであ...」
- Score 0.8511: 「日本は立憲君主制と議院内閣制を組み合わせた国家体制をとってい...」
日本の領土は、日本列島(大日本帝国)から構成されています。日本の領土は、日本列島(日本国民連合軍総司令部)から構成されます。日本の領土は、日本列島(日本国民連合軍総司令部)から構成され、日本の国土を統治する政府直轄領です。(以下同様の文が反復)
User: アメリカとは
検索結果(上位2件):
- Score 0.8122: 「日本の公用語は法律で明記されていないが、事実上日本語のみであ...」
- Score 0.8063: 「日本の名目GDPは世界で上位に位置し、長年アメリカに次ぐ世界...」
イギリスとフランスは、この2国間経済連携協定により、ロンドンやニューヨークの「ロンドン・ビジネス・センター」を共同設立した。ロンドン・ビジネス・センターはロンドン証券取引所とロンドン証券取引所プライム市場に上場しており、ロンドン証券取引所はロンドン証券取引所の子会社である。
10章・11章のプロンプトなしの生成と比べると、「東京とは」の回答は検索結果をきちんと踏まえた自然な文章になっており、プロンプトベースRAGの効果がはっきり出ている。一方で「日本とは」は同じ文の反復に陥り、「アメリカとは」に至っては検索結果自体が2件ともアメリカに関する内容を含んでおらず、結果としてモデルは無関係なイギリス・フランスの話を生成している。検索対象コーパスがわずか50件しかないため、アメリカに関する記事がそもそも収録されていなかった可能性が高い。コーパス規模そのものが検索の再現率、ひいては生成の質の上限を決めることが分かる例になっている。
もう一点、実装側の問題として、類似度スコアによる足切りを設けていないことが挙げられる。「アメリカとは」の例でもスコアは0.81前後あり、一見関連していそうに見えるが、これは検索対象がそもそも日本語コーパスに限られているため、どんな質問でもこの程度のベーススコアは出てしまう。スコアが一定の閾値を下回った場合は「関連文書なし」として検索結果をプロンプトに含めない、といったガードを入れていなかったため、無関係な文書からでも強引に回答を捻り出す挙動につながった。コーパス規模の不足と、この足切りロジックの欠如という2つの要因が重なった結果と言える。
12.2 RAG用の追加学習と過学習
一方、SFT済みモデルに対し、RAG用途を見据えた追加学習を行ったところ、過学習を起こしてしまった。
症状としては、どんな質問を投げても「知らない」「わからない」といった回答しか返さなくなる、というもの。原因はデータの偏りというより、評価関数(損失関数)自体のバグだった。モデルにとって「知らない」と答える方が、実際に(正しいかどうか分からない)回答を試みるよりも損失(ペナルティ)が小さく済む抜け道が評価関数に存在しており、モデルはそれを的確に突いてきた形になる。本来なら知っているはずの内容にまで「知らない」で応じるのは、モデルが自信なく答えているというより、損失を最小化する最適解として拒否を選んでいるだけ、というのが実態に近い。
厳密には、reward hackingという用語はRLHFなど報酬最適化の文脈で使われることが多く、今回のSFTは損失関数を直接最小化する教師あり学習であるため、正確には「loss minimization artifact」や「shortcut learning(近道学習)」と呼ぶ方が適切かもしれない。とはいえ、モデルが評価指標の抜け道を見つけて本来意図しない挙動に最適化されたという意味では、広義のreward hackingに近い現象と言える。モデルの能力不足というより、こちらが設計した評価関数の設計ミスが直接の原因であることに変わりはない。「知らないと答える」という選択肢が持つ罰則の重みと、「間違った回答をする」という選択肢が持つ罰則の重みのバランスが崩れていたため、モデルは最も安全(=低損失)な出力として拒否を選び続けるようになった。
13. 次にやりたいこと
次は350Mパラメータ・15Bトークン規模での事前学習を予定している。
Chinchilla則(パラメータ数の約20倍のトークン数が計算最適)に従うなら350M × 20 ≒ 7Bトークンが目安になるが、今回は意図的にその2倍以上となる15Bトークンを投入する。LlamaやQwen、Gemmaといった昨今の主要モデルは、推論コストや実用上の性能を重視してChinchilla最適点よりも多くのトークンで学習する傾向(overtraining)にあり、その流れを踏まえた設定にした。
14. これから作る人へ
同じように個人でLLMの事前学習に挑戦しようとする人に向けて、今回の経験から得た教訓を簡単にまとめておく。
- VRAM 8GBでも1億パラメータ級なら現実的。物理バッチサイズを極端に絞り、勾配累積で実効バッチサイズを確保すれば、コンシューマ向けGPU1枚でも事前学習は最後まで走らせられる。
- OOM対策は事前学習・SFT問わず必ずどこかで刺さる。
np.memmap、streaming=True、limit_alphabetなど、メモリを一括で確保しない設計を最初から前提にしておいた方がいい。 - 評価関数・報酬設計はモデルの学習内容そのものより注意が必要。今回のRAG追加学習の過学習は、モデルの能力不足ではなく評価関数の抜け道が原因だった。損失や報酬の設計ミスは、データやモデルのミスよりも気づきにくい。
- SFTは「型」を教えるもので「知識」を増やすものではない。この規模感では特に顕著で、応答の振る舞いは変わっても事実の正確性はほぼ変わらない。
- 検索(RAG)の質は元のコーパス規模にそのまま比例する。50件程度のコーパスでは、質問によっては関連文書が1件も存在しないことがあり、その場合は生成もそれに引きずられる。類似度の閾値による足切りは早い段階で入れておくべきだった。
- 「作れるか」と「使えるか」は別の問い。1億パラメータ規模でパイプライン全体を一通り動かすこと自体は十分に達成可能な目標なので、完成度を追い求めるより、まず最後まで通しで動かし切ることを優先した方が学びが多い。
15. 謝辞
本プロジェクトは、以下の公開データセットを利用させていただいた。各データセットの制作者・公開者に感謝する。
| データセット | 用途 | ライセンス |
|---|---|---|
matsuo-lab/JP-LLM-Corpus-PII-Filtered-10B |
事前学習コーパス(50%) | CommonCrawl由来のCCライセンスを継承(詳細は元データソースを参照) |
wikimedia/wikipedia(20231101.ja) |
事前学習コーパス(30%) | CC BY-SA 3.0 / GFDL * |
globis-university/aozorabunko-clean |
事前学習コーパス(20%) | パブリックドメイン(CC BY 4.0相当で配布) |
kunishou/databricks-dolly-15k-ja |
SFT用データセット | CC BY-SA 3.0 * |
* CC BY-SA(継承系・Share-Alike)ライセンスは、派生物を同一ライセンスで公開することなどの条件を課す。利用にあたっては各データセットの一次情報源を参照のこと。本記載は法的助言ではない。
16. コード
本記事で扱った実装の全体は以下のリポジトリで公開している。
github.com/onemunanoyo/109MParameterLLM
17. 参考文献
本記事で採用した各技術の原論文は以下の通り。
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems 30 (NeurIPS 2017).
- Sennrich, R., Haddow, B., & Birch, A. (2016). Neural Machine Translation of Rare Words with Subword Units. Proceedings of ACL 2016. arXiv:1508.07909.
- Su, J., Ahmed, M., Lu, Y., Pan, S., Bo, W., & Liu, Y. (2024). RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing, 568, 127063. arXiv:2104.09864.
- Zhang, B., & Sennrich, R. (2019). Root Mean Square Layer Normalization. Advances in Neural Information Processing Systems 32 (NeurIPS 2019). arXiv:1910.07467.
- Shazeer, N. (2020). GLU Variants Improve Transformer. arXiv:2002.05202.
- Dao, T., Fu, D. Y., Ermon, S., Rudra, A., & Ré, C. (2022). FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). arXiv:2205.14135.
- Loshchilov, I., & Hutter, F. (2019). Decoupled Weight Decay Regularization. International Conference on Learning Representations (ICLR 2019). arXiv:1711.05101.
- Touvron, H., Lavril, T., Izacard, G., Martinet, X., Lachaux, M.-A., Lacroix, T., Rozière, B., Goyal, N., Hambro, E., Azhar, F., Rodriguez, A., Joulin, A., Grave, E., & Lample, G. (2023). LLaMA: Open and Efficient Foundation Language Models. arXiv:2302.13971.
- Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., Rutherford, E., de Las Casas, D., Hendricks, L. A., Welbl, J., Clark, A., Hennigan, T., Noland, E., Millican, K., van den Driessche, G., Damoc, B., Guy, A., Osindero, S., Simonyan, K., Elsen, E., Rae, J. W., Vinyals, O., & Sifre, L. (2022). Training Compute-Optimal Large Language Models. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). arXiv:2203.15556.
- Schulman, J., Wolski, F., Dhariwal, P., Radford, A., & Klimov, O. (2017). Proximal Policy Optimization Algorithms. arXiv:1707.06347.